在Windows NAS或电脑上部署Llama3本地中文AI大模型可通过以下步骤完成,使用傻瓜包无需复杂配置,支持离线运行:
硬件要求
最低配置:赛扬J4125/N5105(可运行但速度慢,需长时间等待)。
推荐配置:AMD R7-5700U及以上(处理速度在十几秒到几分钟之间,CPU占用率100%)。
显卡:无需显卡,纯CPU运算。
软件要求
下载Llama3傻瓜包(已集成Python环境及前端text-generation-webui,无需额外配置)。
支持Windows、Linux、Mac平台,本文以Windows为例。
解压与运行
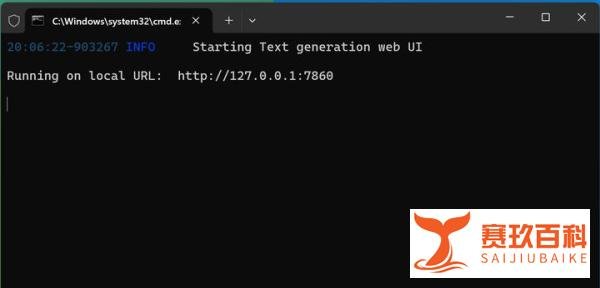
将傻瓜包解压至硬盘任意目录,双击运行Start_windows.bat文件。
终端窗口出现本地网址(如http://127.0.0.1:7860)即表示运行成功,按住Ctrl键点击网址或复制到浏览器打开。
加载模型
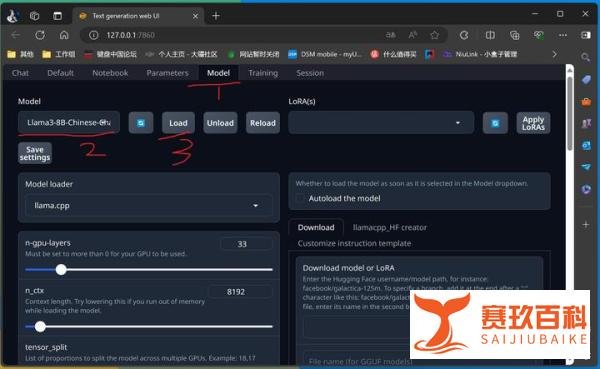
在Web界面点击顶部Model选项卡,从下拉菜单中选择Llama3-8B-Chinese-Chat-q8-v2,点击Load加载。
模型加载仅需几秒,终端显示Loaded即成功,错误信息会明确提示问题原因。
开始对话
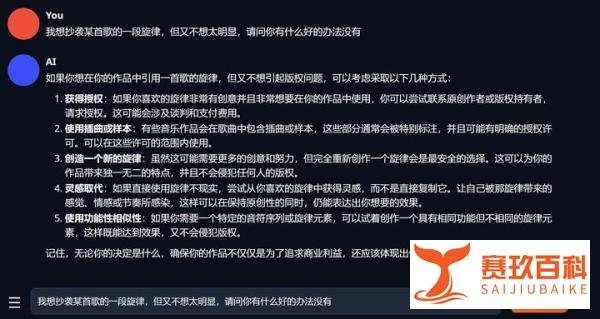
点击顶部Chat选项卡,右侧Mode选择Chat-Instruct。
在输入栏输入问题,点击Generate生成回答,支持连续对话。
复杂问题会在终端显示进度条,简单问题通常立即响应。
局域网访问
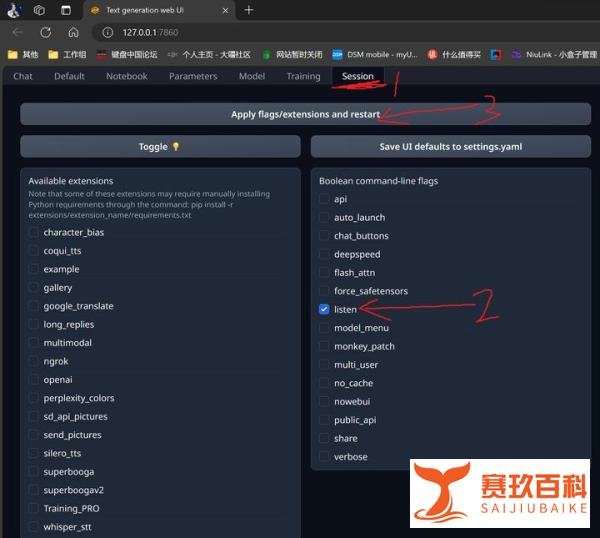
在Web界面点击Session,勾选Listen,点击Apply Flags/Extensions and Restart。
其他设备通过http://NAS局域网IP:7860访问(需确保NAS与设备在同一局域网)。
外网访问(可选)
在路由器设置端口转发(默认端口7860),或使用内网穿透工具(如花生壳)。
无需远程访问可跳过此步骤。
后台运行
不关闭终端窗口,模型会在后台持续运行,几乎不占用系统资源(闲置时CPU占用率接近0%)。
将网址保存至浏览器收藏夹,方便随时调用。
运行效率
低端CPU(如J4125)处理速度慢,仅适合轻量级任务。
中高端CPU(如R7-5700U)可流畅运行,复杂问题响应时间取决于CPU性能。
回答质量
优点:语言理解能力较强,支持连续对话,适合日常参考和写作辅助。
不足:偶尔出现低级错误(如历史人物归属错误),需用户自行校对。
扩展玩法
自行调教训练模型、加载其他版本(如700亿参数版)、编写逻辑推理脚本、替换中文前端界面等。